自作ナレッジ基盤の構築
- 自分に纏わる情報を一箇所に集約し、横断的に活用するための個人用のナレッジ基盤を作っている
- 過去に書いた記事や資料を検索し、稼働記録や給与明細のような数値データをダッシュボードで可視化し、新しい記事や作品を作るときの材料として引く、という3つの用途がある
- 前身となる自作のライフログ管理・分析基盤を、AIエージェントが中心になって動く前提で作り直し、扱う対象も数値データから文章まで広げた
前身プロジェクト
Section titled “前身プロジェクト”- 2023年春頃から運用しており、データソースはSwitchBotの消費電力・気温・湿度 / ポモドーロタイマーの記録 / 給与明細のPDFの3種類だった
- SQLAlchemyのモデルとAlembicのマイグレーションでスキーマを定義し、Pythonで書いたインポート用のクラスでパースしてSQLiteに入れていた
- 可視化はDocker Composeで起動するMetabase上でSQLを書いて行っていた
- 全てのデータソースを単一のスキーマに正規化してSQLiteへ入れる構造だったため、記事や議事録のような文章の置き場所がなかった
- 文章はObsidianで別管理していたが、UIが個人的にしっくり来ず、特定のエディタに依存する形になっていた
- データソースを1つ増やすだけでも、モデルの定義 / マイグレーションの生成 / インポート用クラスの追加という定型作業が必要で、拡張性に乏しかった
- SwitchBotのデータは整備が大変な割に活用が難しく、大抵の場合はリアルタイムの確認だけで事足りたため廃止した
- 可視化の定義がMetabase側のデータベースに閉じていて、Git管理の外に出てしまっていた
- Docker Composeによる常時起動が必要な点も、個人用の基盤としては重かった
- そもそもAIエージェントから使う想定がなく、蓄積したデータを読むにはSQLを書く必要があった
モチベーション
Section titled “モチベーション”- 過去の資産を横断的に活用できるようにしたかった
- 検索して確認したり、抜き出して新しい資料として再構成したりする
- 資料同士の関連付けから新しいアイデアを得る
- データの蓄積から傾向を得て意思決定の材料にする
- この関連付けから着想を得るという狙いは、メモ1枚の価値が他のメモとのリンクで決まるとするルーマンのZettelkastenの考え方に近い
- 集約するだけで終わらせず、そこから知識や知恵を引き出したいという方向性は、データが情報・知識・知恵へと段を上がるDIKWモデルの語彙でも整理できる
- 作品制作 / 日々の検証 / 手順書の作成において、文章の整理という非本質的な部分にかかる工数を削り、デリバリーを速くしたかった
- これからのソフトウェアエンジニアリングは、人が1つずつ実装するのではなく、環境を整えてAIエージェントに任せる形へ移っていくと見ている
- その環境を自分の手元に持つために、ハーネスエンジニアリングやループエンジニアリングの実験場にするという狙いもある
価値の置きどころ
Section titled “価値の置きどころ”- 価値の源泉は、自分が直接触れてきたもの・生み出してきたものの集約であることだと考えている
- 他人のソースを勝手に拾い集めて育っていくwikiだとしたら、LLMの上にもう一段薄いレイヤーを重ねているだけになる
- そうしたwikiの中身はLLM自身がRAG(Retrieval-Augmented Generation)なしでもある程度出せてしまうため、情報としての新規性がほぼゼロになる
- 境界線はソースが他人かどうかより、そこに自分自身の判断・取捨選択が乗っているかどうかに置いている
- 他人の記事でも、読んで自分の問題意識とどう繋がるかを見極めて残すなら、一次的な判断が乗った価値になる
- 逆にLLMが自律的に拾ってくる部分が増えるほど、価値の薄い構造に近づいていく
ディレクトリ構成
Section titled “ディレクトリ構成”knowledge/{source}/は過去に書いた記事・資料をそのままマークダウン化して置く場所で、過去資産の原本という位置付けから原則として改変しない- マークダウンのファイルをGitリポジトリに直接置いているため、特定のエディタに依存しない
drafts/は作成途中の記事を置く場所で、.gitignoreの対象にしている- 進捗度合いで
sketch/(草案) /wip/(作成中) /ready/(完成・未公開)に分け、公開後にknowledge/へ移す
- 進捗度合いで
data/{source}.csvはknowledge/内の生データから抽出・集計した分析用データで、ダッシュボードへの描画対象となるscripts/には条件分岐として書き下せる処理をCLIスクリプトとして置き、.claude/skills/には書き下せない読解・視覚判断を要する定型作業を置くdashboard/は Streamlit で書いた可視化の置き場所になる.github/には日次のissueを作るGitHub Actionsのワークフローを置く
扱っている情報
Section titled “扱っている情報”- 定期的に更新されるソースは取得をスクリプト化し、更新頻度が低いものはAIエージェントにオンデマンドに変換してもらっている
- 正規化をやめてソースごとの形のまま置いているため、ソースを足すときもスキーマの定義やマイグレーションは要らず、取得スクリプトの追加と、後述するskillへの1行追記で済む
- 前身で扱っていたSwitchBotのセンサ系は、前述した理由から引き継いでいない
| ソース | 内容 | 取り込み方 |
|---|---|---|
| mtg | うゆぷんの月次報告 | 定期取得 |
| takada-semi | 高田ゼミの記事 | 定期取得 |
| note | note.comの記事 | 定期取得 |
| assets | うゆぷんのイベント資料 | 定期取得 |
| github | コントリビュート数 | 定期取得 |
| youtube | 主担当として制作した動画 | 定期取得 |
| spotify | 年間トップ曲 | 年1回の取得 |
| qiita / hatena | 技術記事 | 都度変換 |
| slides / profile / misc | 手元のスライドや職務経歴書等 | 都度変換 |
| payslip | 給与明細のPDFと作業ログ | 都度変換 |
| pomodoro | ポモドーロの稼働記録 | 都度貼り付け |
| daily | 日次のTODOと振り返り | GitHub Actionsで自動生成 |
- 記事・資料として置いているマークダウンファイルは、800件弱ある
data/配下のうち決定論的な抽出は、生成元1件につき1行として実行のたびに全件再生成するため、何度実行しても同じ結果になる- 読解を伴う抽出は既存ファイルに追記し、チェックポイントファイルで差分管理することで、読解のコストを払い直さずに済む
- ロジックはCLIから単体実行できるスクリプトを正として整備し、どれも
uv run scripts/*.pyの形で叩けるようにしている - 名前で役割が分かるように、接頭辞を揃えている
| 接頭辞 | 役割 |
|---|---|
fetch_*.py |
外部ソースからの取得 |
extract_*.py / normalize_*.py |
取得したファイルから分析用データへの変換 |
convert_*.py / format_*.py / unlock_*.py |
マークダウン化や整形、ロック解除といった決定論的な後処理 |
append_*.py / add_*.py |
ポモドーロの記録やGitHub Projectへの追記 |
- 外部APIを叩くものは差分実行にしており、
fetch_github_contributions.pyは前回取得済みの最新日以降のみ、fetch_spotify_genres.pyは未取得のアーティストのみを取る - MarkItDown によるPDF/PPTX変換では文字化けや制御文字が決まった形で混ざるため、
text_cleanup.pyで機械的に除去できる分だけを落としている format_bullet_article.pyだけはknowledge/の既存資産ではなくdrafts/で執筆中の記事にかけるもので、太字の除去や全角記号の半角化のように判読が不要な整形を担う
skills
Section titled “skills”- skillは現在8つで、どういう言い回しの依頼で発火するかと、読むときの判断の基準を自然言語で書いている
| skill | 役割 |
|---|---|
| route-knowledge-source | 曖昧な依頼やファイル追加から、実行すべきスクリプトとその順序を判断する |
| sync-all-sources | 定期取得のソースをまとめて更新し、ソースごとの扱いと順序を振り分ける |
| fix-markitdown-conversion | PDFやPPTX由来のマークダウンの崩れを、元ファイルの見た目と比べて直す |
| bullet-style-article-proofreading | 執筆中の箇条書き記事の構成や表記を校正する |
| revise-proofreading-tools | 執筆で得た校正の知見を、スクリプトと校正skillに振り分けて反映する |
| extract-mtg-experiences | 月次報告の自由記述から美術館 / ライブ / 映画 / 読書の体験を抽出する |
| add-project-task | やりたいことをGitHub Projectへ追加し、重複の確認とカテゴリの判定を行う |
| record-pomodoro-sessions | 貼り付けた時刻レンジをポモドーロの記録として追記する |
fix-markitdown-conversionでは、文字コードの誤マッピングと制御文字の除去を決定論的な処理としてスクリプトに置き、文がどこで分断されたかの判断は元ファイルを見ないと決まらないためskillに置いているextract-mtg-experiencesでは、体験がツアー名や展覧会名といった固有名詞だけで書かれていて単純なキーワード一致では拾えないため、カテゴリの定義と判断に迷ったときの扱いをskillに書き下しているrevise-proofreading-toolsは校正の道具そのものを直すためのskillで、記事を1本書き終えるたびに、その執筆で実際に出た指摘を機械的に直せるものと読解が要るものに仕分けて、前者をスクリプトへ、後者をbullet-style-article-proofreadingのルールへ反映している- ルールが単調に増え続けないよう、追加と同じ回のうちに既存ルールの圧縮まで行う
- 毎朝5時にGitHub ActionsがTODOのテンプレートを
dailyラベル付きのissueとして作成する - issueのコメントで
/carryoverとすると、前日のissueから、毎日のルーティンを除く未完了項目を引き継ぐ - 一日の中でTODOの消化状況や感情の動きをコメントに書き足していく
- 一日の終わりに
/lookbackとすると、Claude Codeによる振り返りが投稿され、knowledge/daily/{year}/{month}/{day}.mdとして保存されてissueがcloseされる - この日次ログは500件近く溜まってナレッジの中で最も件数の多いソースになっているが、事後的な活用はまだほとんどできていない
- この仕組み自体は GitHub Actionsで人生のPDCAをぶん回す と Claude Code GitHub Actionsを振り返りに活用している で過去に詳しく紹介している
ダッシュボード
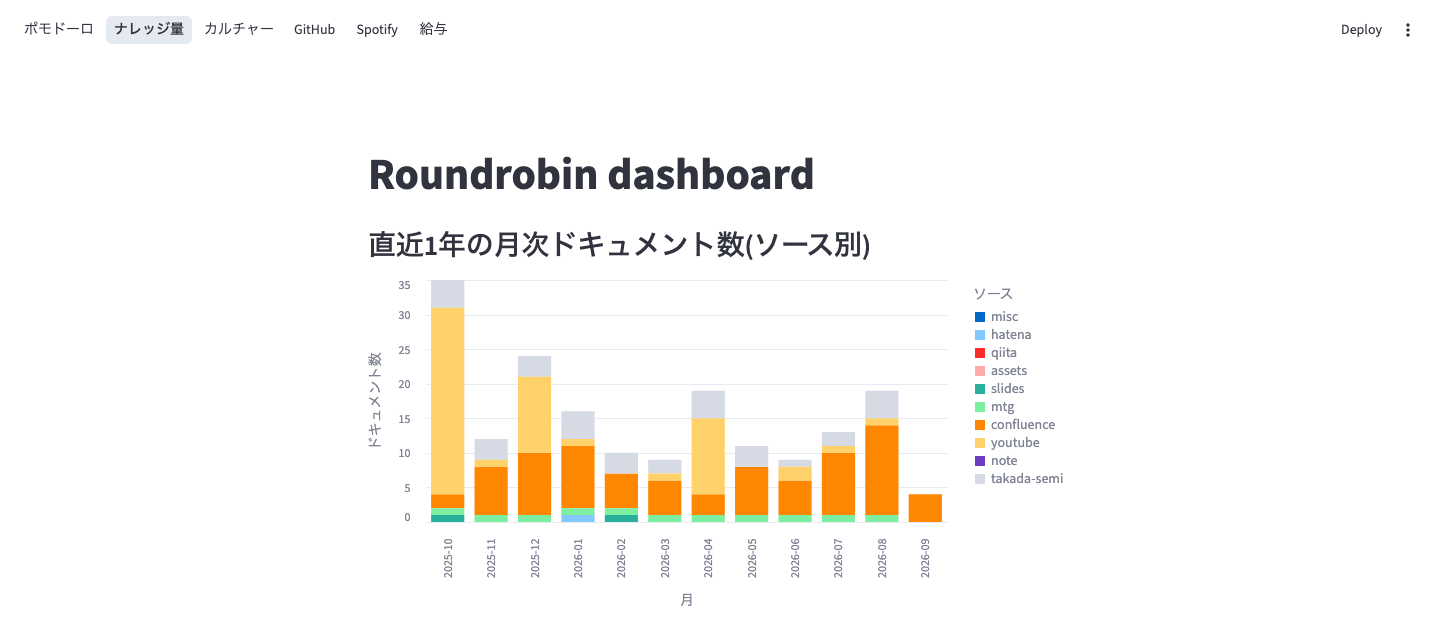
Section titled “ダッシュボード”data/とknowledge/を入力に、ポモドーロ / ナレッジ量 / カルチャー / GitHub / Spotify / 給与の6タブを用意している- どのタブも年や月を軸にした時系列で並べ、時期ごとの偏りが見えるようにしている
- 可視化の定義がPythonのコードとしてGit管理下に入ったのが、Metabaseからの一番の変化になっている
- 常時起動のコンテナが不要になり、
uv run streamlit run dashboard/app.pyだけで立ち上がるようになった
- 検索はAIエージェントに
knowledge/配下のマークダウンファイルをgrepさせるだけで、技術文書が中心で語彙も揺れにくいため今のところ足りている - ただし件数はベクトル検索が優位になるとされる数百本規模に達しており、インデックスの導入を再検討する段階に来ている
- 意味検索を入れる場合は、マークダウンファイルを正としたまま SQLite FTS5 やベクトルDBのインデックスを別に生成する二段構えになる
- 記事同士を明示的に繋ぐwikilinksを検索軸として持たせる案もあり、 ReMe のようにキーワード検索や埋め込みと組み合わせる構成を参考にしている
- ブラウザのブックマークやChatGPTの会話ログのような、まだ手を付けていない個人データの取り込みも検討している
- ダッシュボードは今のところローカルでしか動かしておらず、認証付きでStreamlit Community Cloudにデプロイしたい
- 過去にこういう記事を書いたなと思い出したときに、すぐ引っ張ってこられるのがかなり便利になった
- 記事を書くときの非本質的な部分も大きく減り、執筆の速度は目に見えて上がった
- 以前は1つの記事を集中して書くという形だったが、複数の記事が同時に少しずつ自然にできていく形に変わった
- 過去の実測値をグラフで見られることで、定量的な目標が立てやすく、モチベーションにもなっている
- いかにして技術記事を書くか で書いた執筆の進め方も、この基盤の上でまた組み替わってきているので、この点に関しては別途、紹介したい